
한 장의 그림으로 이해하기
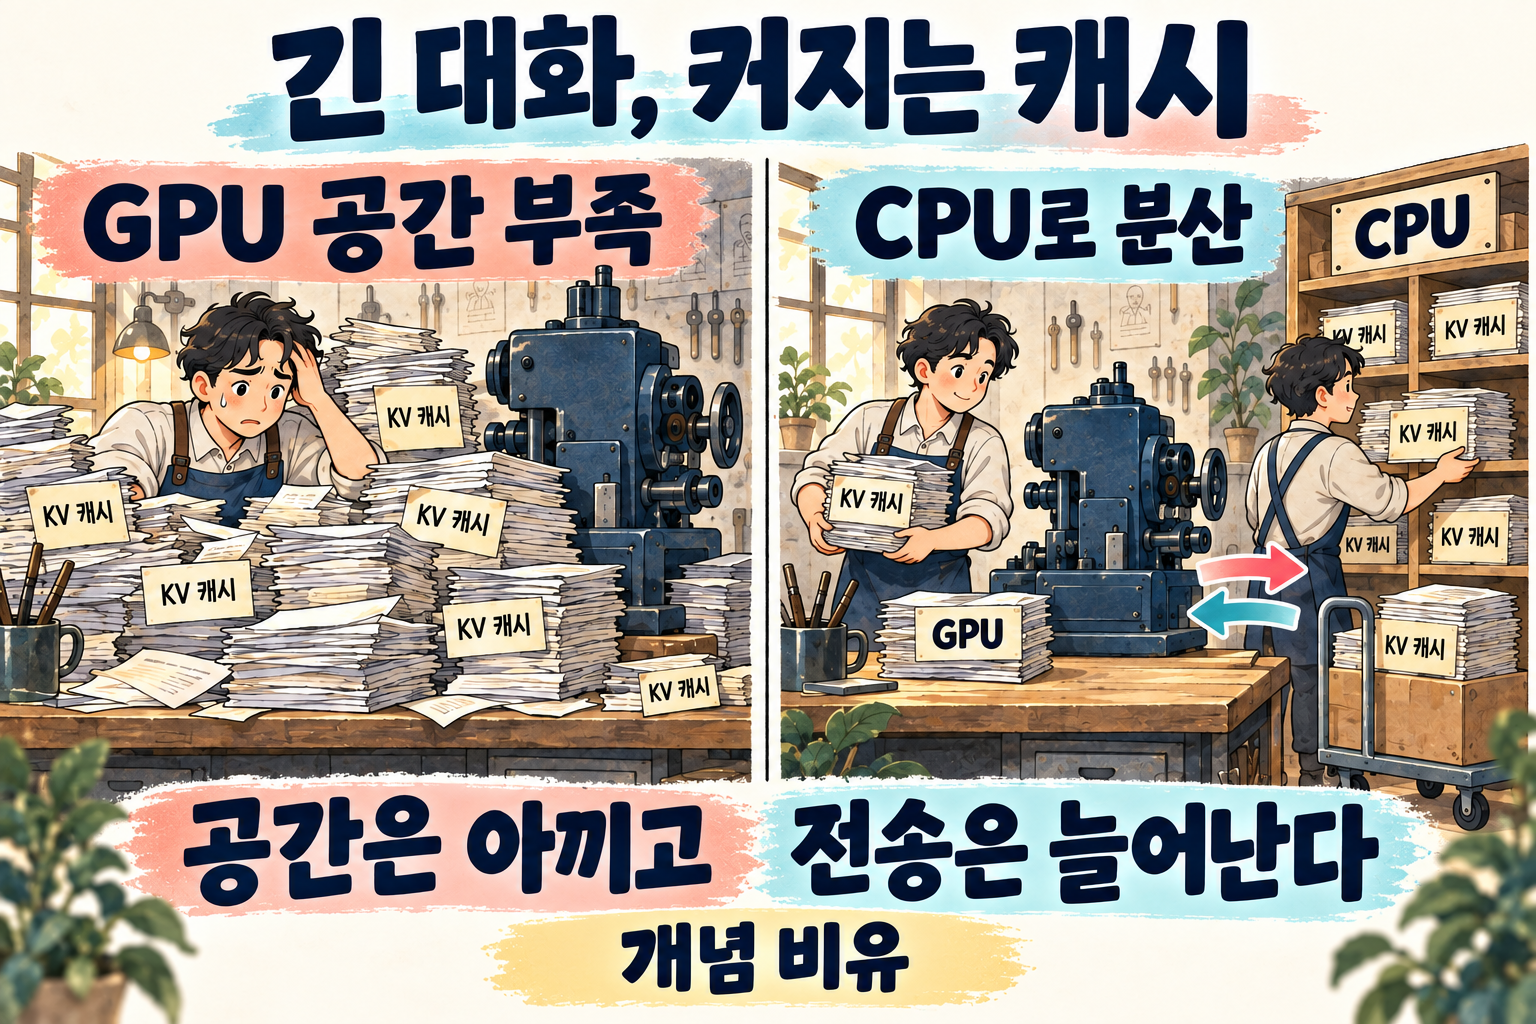
그림 크게 보기 ↗ (새 탭)
오픈 모델 · 판정 관망
그림을 글로 풀면
긴 대화의 메모리 사용 분리하기
모델 자체와 KV 캐시를 나누고, CPU 분산의 공간·전송 교환을 살펴봅니다.
- 대상
- 내 GPU에서 오픈 모델 추론을 시험하는 개발자
- 무엇이 바뀜
- KV 캐시를 CPU로 옮겨 GPU 메모리를 아낄 수 있습니다.
- 왜 중요한가
- 캐시 이동은 여유 공간을 만들 수 있지만 전송 때문에 처리량이 낮아질 수 있습니다.
- 지금 할 일
- 같은 모델·입력·출력 조건에서 캐시 설정과 메모리·속도를 함께 기록합니다.
- 한계·미확인
- 모든 메모리 부족의 해결책이 아니며 모델·장비별 효과와 성능은 시험하지 않았습니다.
- 공식 출처
- huggingface.co
- 확인일
- 2026-09-18
기계가 그대로여도 작업 메모는 커질 수 있다
KV 캐시는 이전 토큰의 계산 정보를 다시 쓰기 위해 보관합니다. 기본 동적 캐시는 생성이 이어지면서 커질 수 있습니다. 다만 슬라이딩 윈도나 청크 어텐션을 쓰는 레이어는 해당 범위에서 성장이 멈춥니다. 그림의 쌓이는 종이는 모든 모델이 무한히 메모리를 늘린다는 뜻이 아닙니다.
캐시를 옮기면 GPU 밖에서도 일이 생긴다
공식 문서의 오프로딩은 레이어별 캐시를 CPU와 GPU 사이에서 옮기는 방식입니다. 현재 계산에 필요한 캐시를 GPU에서 사용하고 다음 것을 준비합니다. 모델 자체를 옮기는 설명과는 구분해야 합니다. 전송이 추가되므로 GPU 공간이 절약되어도 처리량은 낮아질 수 있습니다.
한 번에 설정 하나를 바꿔 비교하기
가상의 로컬 상담 모델 실험이라면 먼저 같은 모델과 대화 길이, 출력 조건을 고정하고 캐시 설정만 바꾸는 비교를 제안합니다. 최대 메모리와 생성 시간을 함께 적어야 공간 절약의 대가를 볼 수 있습니다. 이 글은 코드를 실행하지 않았으며 메모리 부족이 반드시 캐시 때문이라고 진단하지 않습니다.
참고 원문: Hugging Face Transformers v5.17.0 캐시 전략 문서 · 원문 게시일 상시 문서(게시일 미표기) · 확인일 2026-09-18
AI 작성·자동 검증: 공식 자료와의 대조 및 게시 구조 검사. 사람의 개별 검수와 제품 실행 시험은 수행하지 않았습니다. 그림은 신규 생성한 개념 일러스트입니다.
이 글의 검증 카드
- 자료 버전
- Hugging Face Transformers v5.17.0 Cache strategies, 2026-09-18 확인; 모델 실행 미검증
- 확인일
- 2026-09-18
- 검증 상태
- 개발자 주장
- 한계·주의
- 모든 메모리 부족의 해결책이 아니며 모델·장비별 효과와 성능은 시험하지 않았습니다.
함께 더 정확하게
질문·오류 제보
그림에서 이해되지 않는 부분이나 달라진 내용을 알려 주세요. 관리자가 확인하고 승인한 글만 공개됩니다.
개발에서는 이메일 인증 가입 또는 관리자 발급 계정으로 참여할 수 있습니다. 계정·이용 문의
아직 계정이 없으신가요? 회원가입
공개된 질문·제보
아직 공개된 질문·제보가 없습니다. 궁금한 부분을 먼저 남겨 주세요.