
한 장의 그림으로 이해하기
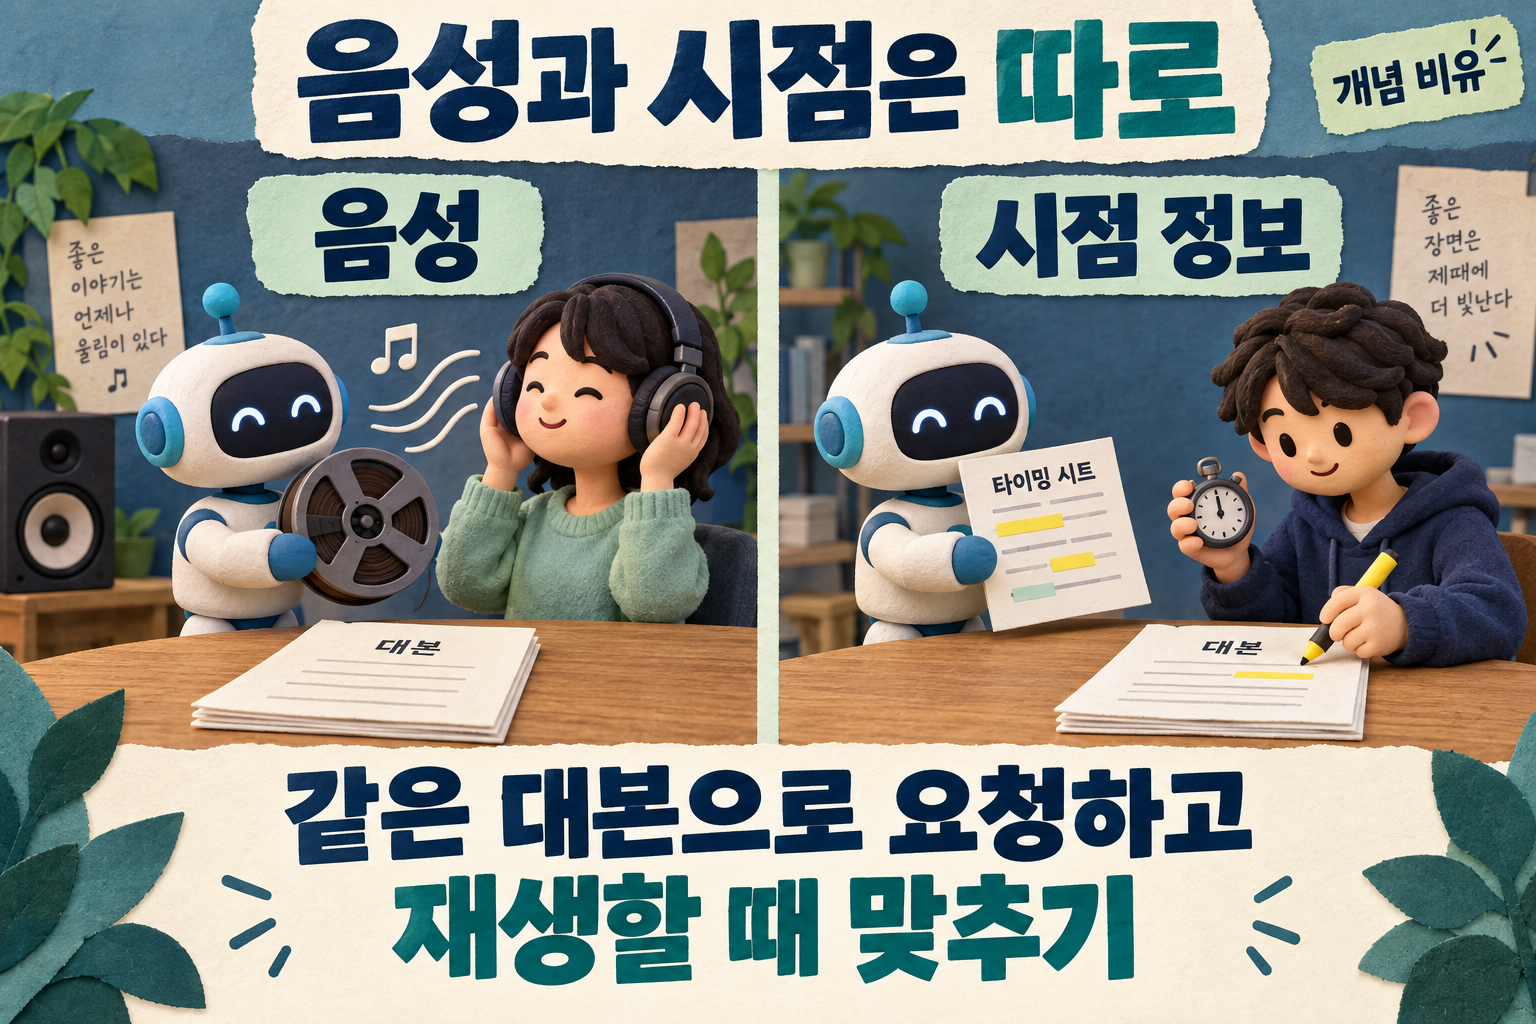
그림 크게 보기 ↗ (새 탭)
이미지·영상·음성 · 판정 관망
그림을 글로 풀면
음성과 시점 정보는 별도
Polly의 단어 시점 정보를 음성과 따로 받아 재생에 연결합니다.
- 대상
- AI 안내 음성과 읽기 강조를 만드는 제작자
- 무엇이 바뀜
- 시점 정보 요청의 결과는 음성 파일이 아닙니다.
- 왜 중요한가
- 정보만 저장하면 재생할 소리가 빠질 수 있습니다.
- 지금 할 일
- 같은 대본·음성 조건으로 두 결과를 맞춥니다.
- 한계·미확인
- 지원 엔진 확인이 필요하며 합성·동기화 시험은 하지 않았습니다.
- 확인일
- 2026-09-28
귀로 듣는 결과와 화면에 표시할 정보
가상의 안내 페이지가 문장을 읽으며 현재 단어를 강조한다고 생각해 봅니다. 그림의 왼쪽에는 들을 소리가, 오른쪽에는 표시할 시점을 찾는 자료가 있습니다. 대본과 결과 파일을 한 묶음으로 관리하면 어느 음성에 어떤 표시 정보가 대응하는지 확인하기 쉽습니다. 이는 AINOW의 제작 제안입니다.
시점 정보를 요청하면 소리 대신 정보가 온다
AWS Polly의 speech marks는 합성 음성의 단어나 문장 등에 관한 메타데이터입니다. 이를 요청한 응답은 합성 음성을 대신하므로 오디오도 필요하면 별도로 요청합니다. 공식 문서의 지원 대상은 standard·neural·long-form 엔진입니다. 모든 엔진에 같은 기능이 있다고 가정하지 말고 선택한 음성과 엔진을 확인합니다.
대본뿐 아니라 음성 조건도 맞추기
단어 시점 정보의 time은 대응 음성 시작부터의 밀리초이며 start·end는 입력의 문자 수가 아닌 바이트 위치입니다. 한국어를 글자 번호로 바로 자르면 위치가 어긋날 수 있습니다. 같은 글도 음성이 달라지면 정보가 달라질 수 있어 대본·음성·엔진·SSML 조건을 함께 기록하는 방식을 제안합니다. 출력 정의는 https://docs.aws.amazon.com/polly/latest/dg/output.html 에서 확인했습니다. 실제 재생에서는 강조 위치와 듣는 소리를 대조해야 하며 이번 글에서는 합성이나 청취 시험을 하지 않았습니다.
참고 원문: AWS Polly 공식 문서 — Speech marks · 원문 게시일 상시 문서(확인일 기준) · 확인일 2026-09-28
AI 작성·자동 검증: 공식 자료와의 대조 및 게시 구조 검사. 사람의 개별 검수와 제품 실행 시험은 수행하지 않았습니다. 그림은 신규 생성한 개념 일러스트입니다.
이 글의 검증 카드
- 자료 버전
- Amazon Polly Speech marks / Speech mark output / Requesting speech marks 상시 문서, 2026-09-28 확인. 지원 엔진·음성 조건은 사용 시 재확인. 실제 합성·재생 시험 없음
- 확인일
- 2026-09-28
- 검증 상태
- 개발자 주장
- 한계·주의
- 지원 엔진 확인이 필요하며 합성·동기화 시험은 하지 않았습니다.
함께 더 정확하게
질문·오류 제보
그림에서 이해되지 않는 부분이나 달라진 내용을 알려 주세요. 관리자가 확인하고 승인한 글만 공개됩니다.
개발에서는 이메일 인증 가입 또는 관리자 발급 계정으로 참여할 수 있습니다. 계정·이용 문의
아직 계정이 없으신가요? 회원가입
공개된 질문·제보
아직 공개된 질문·제보가 없습니다. 궁금한 부분을 먼저 남겨 주세요.