
한 장의 그림으로 이해하기
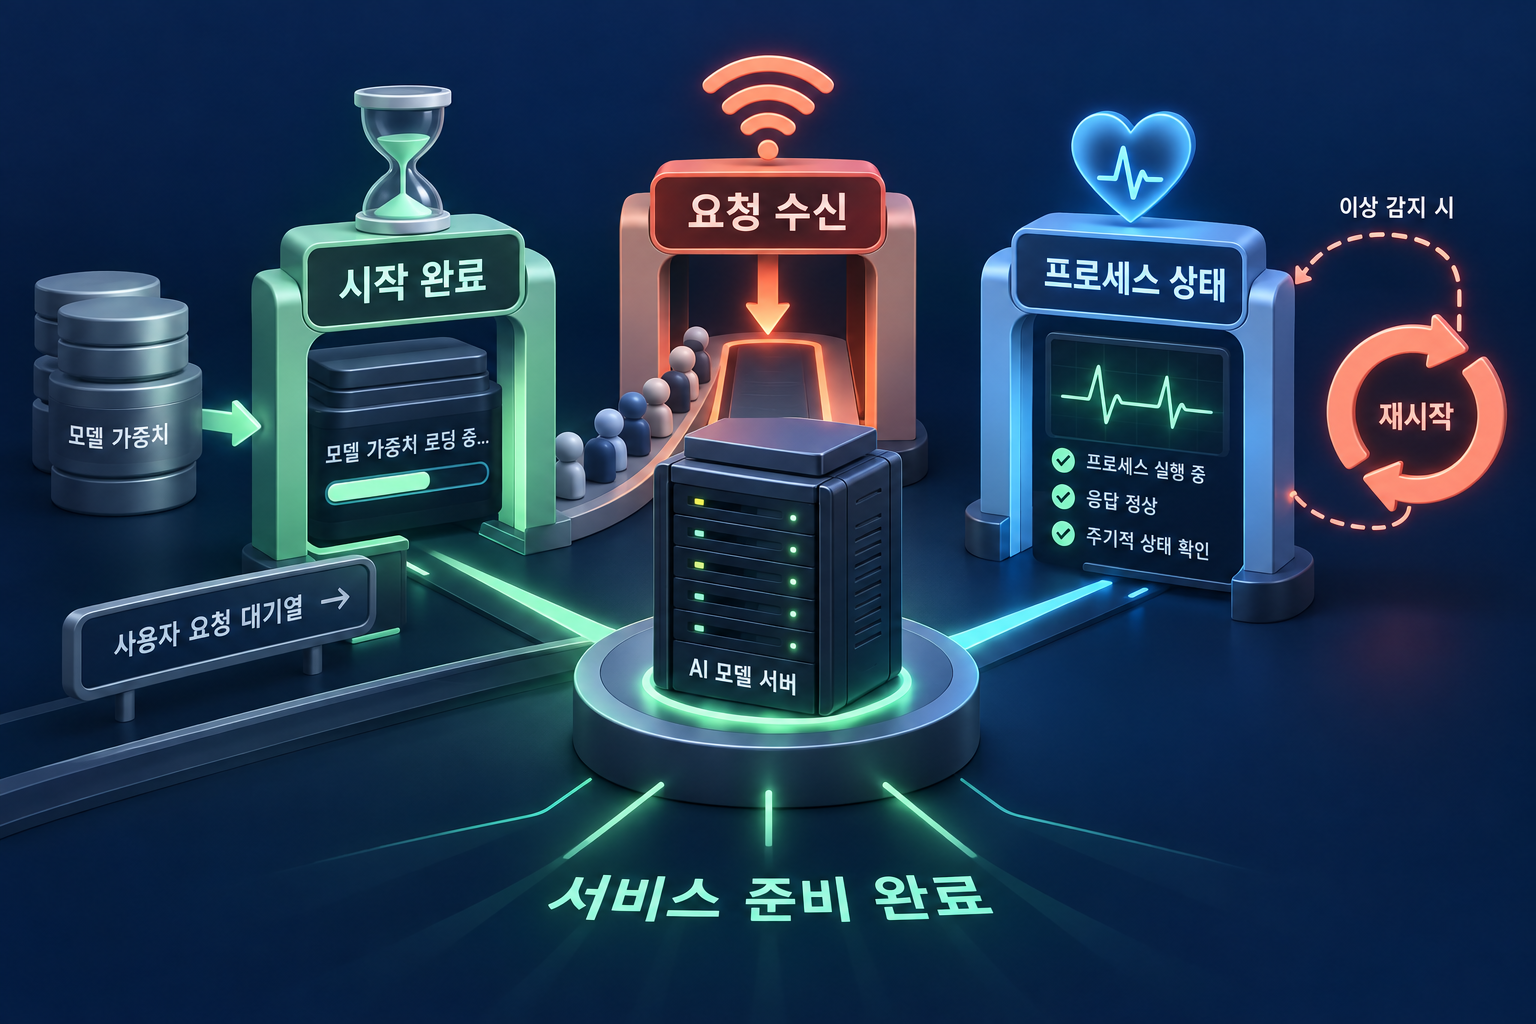
그림 크게 보기 ↗ (새 탭)
개발·오픈소스 · 판정 관망
그림을 글로 풀면
시작·수신·생존 상태 나누기
느린 초기화와 일시적인 요청 불가를 같은 장애로 보지 마세요.
- 대상
- 모델 서버를 Kubernetes에서 운영하는 팀
- 무엇이 바뀜
- 시작 완료·요청 준비·생존 상태를 구분합니다.
- 왜 중요한가
- 준비 전 요청과 불필요한 재시작을 줄이는 설계입니다.
- 지금 할 일
- 각 점검이 실패할 때 필요한 조치를 먼저 적습니다.
- 한계·미확인
- 시작 점검도 실패 한도를 넘으면 재시작 대상이 됩니다.
- 공식 출처
- kubernetes.io
- 확인일
- 2026-09-15
세 질문에 서로 다른 답이 필요하다
Kubernetes의 startup probe는 초기 시작을, readiness probe는 요청을 받을 준비를, liveness probe는 컨테이너의 생존 상태를 점검합니다. 시작 점검을 설정하면 성공 전까지 나머지 두 점검을 기다리게 할 수 있습니다. 준비되지 않은 Pod는 Kubernetes Service를 통한 트래픽에서 제외됩니다. 생존 점검의 반복 실패는 재시작을 유발하며 시작 점검도 실패 한도를 넘으면 재시작 정책의 영향을 받습니다.
모델 가중치를 읽는 시간을 장애와 구분하기
이 그림에서 서버는 모델 가중치를 읽고 있습니다. 프로세스가 떠 있고 포트가 열렸어도 추론 요청을 처리할 준비가 끝났다고 단정할 수 없습니다. 반대로 초기 로딩이 오래 걸린다는 이유만으로 계속 재시작하면 준비를 마칠 기회가 사라질 수 있습니다. 이는 모델 서버에 probe 개념을 적용한 AINOW의 예시이며, 특정 서버가 자동으로 제공하는 점검 경로를 설명한 것은 아닙니다.
AINOW 제안 · 조치부터 역으로 설계하기
상태가 나쁠 때 요청만 멈추면 되는지, 프로세스를 다시 시작해야 하는지부터 적어 보세요. 모델을 읽는 동안에는 대기, 요청 처리에 필요한 준비가 덜 됐다면 수신 제외, 회복되지 않는 프로세스 이상이라면 재시작처럼 조치를 구분할 수 있습니다. 그림은 세 점검의 역할을 나눈 개념도입니다. readiness와 liveness가 반드시 순서대로 통과하는 한 줄의 시험은 아닙니다.
팀이 먼저 모아야 할 기록
운영 환경을 바꾸기 전에 초기화 시간과 실패 원인을 기록해 보세요. 큰 모델과 작은 모델, 캐시가 있는 경우와 없는 경우를 나누면 하나의 임의 시간값으로 모든 배포를 판단하는 실수를 피하는 데 도움이 됩니다. 점검 응답이 지나치게 무거워서 추론 자원을 소모하지 않는지도 살펴볼 항목입니다. 적절한 주기와 실패 횟수는 실제 관측으로 정해야 하며 이 글은 공통 권장 숫자를 제시하지 않습니다.
확인 범위
Kubernetes 문서의 동작 정의를 확인했습니다. 클러스터 배포, 모델 로딩 시간, 부하 시험은 수행하지 않았습니다. 실제 애플리케이션의 건강 상태 경로와 재시작 정책을 확인한 뒤 별도 시험 환경에서 적용해야 합니다.
공식 원문: Kubernetes · Liveness, Readiness and Startup Probes · 원문 게시일 게시일 미확인 · 확인일 2026-09-15
AI 사용: 조사·초안·설명용 이미지 생성. 원문 사진·문장·코드 재사용 없음. 사람 검수·발행 승인: 2026-09-15.
이 글의 검증 카드
- 자료 버전
- Kubernetes 공식 probe 문서 · 2026-09-15 확인 · 특정 클러스터 미검증
- 확인일
- 2026-09-15
- 검증 상태
- 개발자 주장
- 한계·주의
- 시작 점검도 실패 한도를 넘으면 재시작 대상이 됩니다. 공식 문서 기반 자체 해설이며 직접 실행 검증은 하지 않았습니다.
함께 더 정확하게
질문·오류 제보
그림에서 이해되지 않는 부분이나 달라진 내용을 알려 주세요. 관리자가 확인하고 승인한 글만 공개됩니다.
개발에서는 이메일 인증 가입 또는 관리자 발급 계정으로 참여할 수 있습니다. 계정·이용 문의
아직 계정이 없으신가요? 회원가입
공개된 질문·제보
아직 공개된 질문·제보가 없습니다. 궁금한 부분을 먼저 남겨 주세요.