
한 장의 그림으로 이해하기
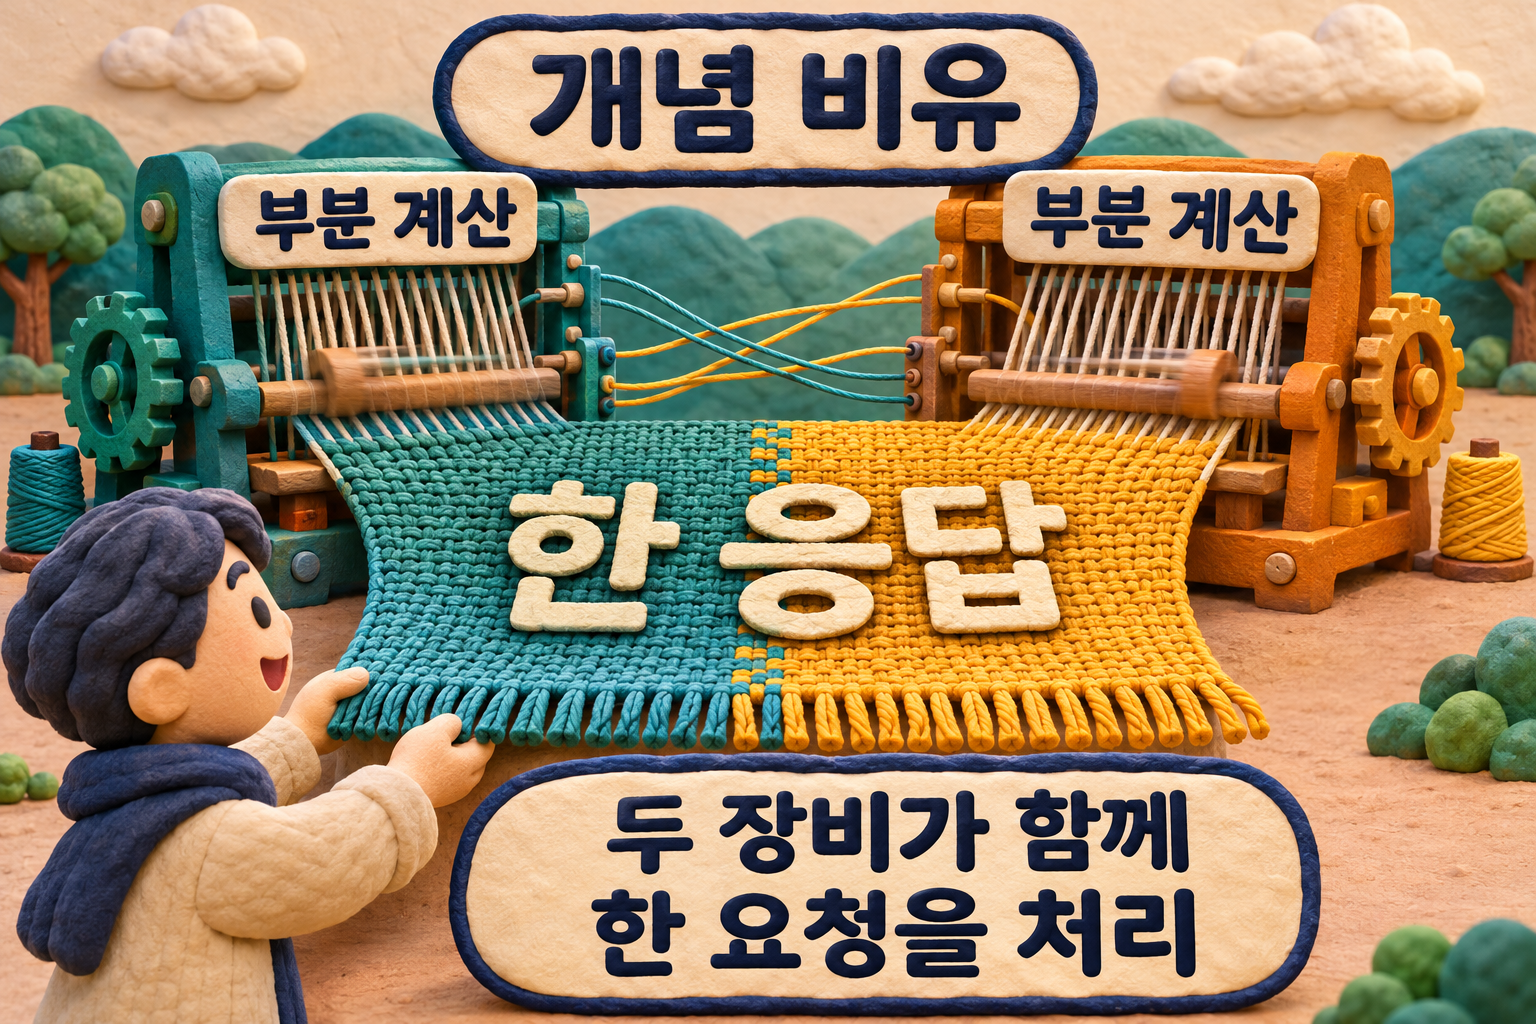
그림 크게 보기 ↗ (새 탭)
오픈 모델 · 판정 관망
그림을 글로 풀면
두 장비가 한 요청을 함께 계산
장비가 두 대라는 사실만으로 요청을 독립적으로 나눠 처리한다고 볼 수 없습니다.
- 대상
- 공개 가중치 모델의 자체 운영을 검토하는 개발자
- 무엇이 바뀜
- NVIDIA 예시는 TP=2로 모델 계산을 두 GPU에 나눕니다.
- 왜 중요한가
- 하나의 API 뒤에서 두 장비가 모두 필요합니다.
- 지금 할 일
- 용량 외에 장비 사이 통신과 장애 영향을 함께 점검하세요.
- 한계·미확인
- 개념 비유. 모델 다운로드·추론·성능 시험 없음.
- 공식 출처
- developer.nvidia.com
- 확인일
- 2026-11-16
먼저 물어볼 것은 장비 수가 아닙니다
가상의 팀이 모델 서버 두 대를 준비합니다. 각 장비가 완전한 모델을 가진 복제 구성인지, 한 모델의 일부를 맡는 구성인지부터 구분해야 합니다. 이 구분에 따라 장비 하나의 장애와 연결 지연이 미치는 영향이 달라집니다.
공식 예시는 한 응답을 함께 계산합니다
NVIDIA의 GLM-5.3 NVFP4 안내는 두 DGX Station을 연결하고 텐서 병렬 크기를 2로 설정합니다. 모델의 가중치와 계산을 두 GPU에 나누며, 두 장비가 각 요청의 계산에 참여합니다. API는 한쪽에서 제공하지만 다른 쪽도 결과를 만드는 데 필요합니다. 두 GPU의 메모리는 물리적으로 별개입니다.
우리 환경에서는 무엇을 검증할까
AINOW는 설치 전에 모델·소프트웨어 버전 일치, 장비 간 통신 경로, 메모리 여유와 장애 대응을 확인하도록 제안합니다. 연결과 실제 부하 시험 없이 처리량을 약속할 수 없습니다. 원문은 모델 이용 조건과 데이터셋 조건도 별도로 안내합니다. 공개 가중치가 무제한 이용 허가를 뜻하지 않으므로 필요한 약관을 확인하세요. 본문은 구조 설명이며 원문의 명령이나 성능 결과를 자체 시험으로 제시하지 않습니다.
참고 원문: NVIDIA 공식 기술 블로그 GLM-5.3 분산 추론 · 원문 게시일 2026-11-13 · 확인일 2026-11-16
AI 작성·자동 검증: 공식 자료와의 대조 및 게시 구조 검사. 사람의 개별 검수와 제품 실행 시험은 수행하지 않았습니다. 그림은 신규 생성한 개념 일러스트입니다.
이 글의 검증 카드
- 자료 버전
- 2026-11-13 글, 2026-11-16 본문 확인. 장비·모델·벤치마크 실행 없음
- 확인일
- 2026-11-16
- 검증 상태
- 개발자 주장
- 한계·주의
- 개념 비유. 모델 다운로드·추론·성능 시험 없음.
함께 더 정확하게
질문·오류 제보
그림에서 이해되지 않는 부분이나 달라진 내용을 알려 주세요. 관리자가 확인하고 승인한 글만 공개됩니다.
개발에서는 이메일 인증 가입 또는 관리자 발급 계정으로 참여할 수 있습니다. 계정·이용 문의
아직 계정이 없으신가요? 회원가입
공개된 질문·제보
아직 공개된 질문·제보가 없습니다. 궁금한 부분을 먼저 남겨 주세요.